Facebook kreeg in oktober naar schatting 40,6 miljoen bezoeken uit Google op pagina's onder facebook.com/fb-answers/. In april waren het er nul. Het zijn AI-samenvattingen van berichten van Facebook-gebruikers, en er staan er miljoenen in de index. Valt dat onder scaled content abuse? Googles beleid laat ruimte voor ja én nee, en Google zelf heeft zich daar, voor zover wij vonden, niet over uitgesproken.
Het cijfer komt van SEO Saul Westbrook van Peripheral Creative, die het uit Semrush haalde. Glenn Gabe schreef er op 5 november op X over: "another example of massive scaled content abuse". Search Engine Roundtable pakte het diezelfde dag op.
Van nul naar 40 miljoen bezoeken in zes maanden
Semrush schat de bezoeken aan /fb-answers/ per maand zo, volgens de tabel in het artikel van Westbrook:
| Maand 2026 | Wereld | VS | Verloop (wereld) |
|---|---|---|---|
| April | 0 | 0 | |
| Mei | 129.514 | 72.617 | |
| Juni | 114.728 | 89.438 | |
| Juli | 1.032.527 | 682.664 | |
| Augustus | 12.167.857 | 6.781.442 | |
| September | 36.388.769 | 23.104.796 | |
| Oktober | 40.590.906 | 21.058.474 |
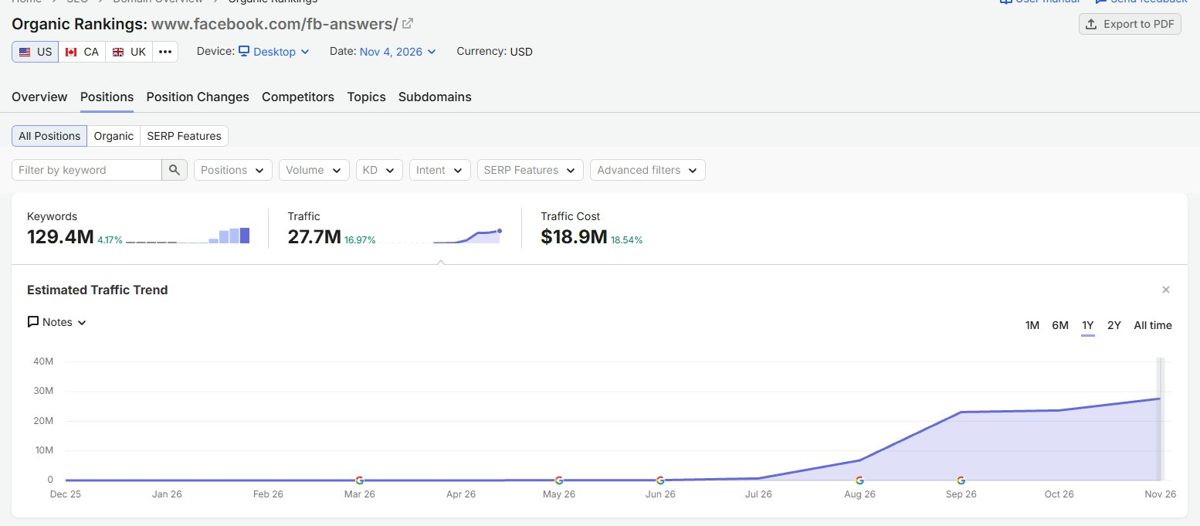
Tussen juli en augustus sprong het aantal zoekwoorden waarop zo'n pagina scoort van 4 miljoen naar 53 miljoen, schrijft Westbrook. Het verkeer volgde een maand later.
Twee dingen kloppen niet helemaal. Westbrook schrijft dat de pagina's "over 100 million visits" kregen sinds de start. Zijn eigen tabel telt voor mei tot en met oktober op tot 90,4 miljoen. Waarschijnlijk is dat afronding of komt november erbij, maar dat staat er niet. En Gabe noemt "6M+ urls indexed", terwijl Westbrook met Semrush op 39 miljoen pagina's komt die in de VS op minstens één zoekwoord ranken. Een site:-telling is grof en Semrush schat. Zeker is dat het er miljoenen zijn. Het precieze aantal weet niemand buiten Facebook, en misschien ook daar niet.
Zijn 6 miljoen AI-pagina's scaled content abuse?
Googles spambeleid definieert het zo: "many pages are generated for the primary purpose of manipulating search rankings and not helping users", "no matter how it's created". Hieronder de voorbeelden uit dat beleid naast wat we over Facebook Answers weten.
| Voorbeeld uit Googles beleid | Past het? | Wat we weten |
|---|---|---|
| Met generatieve AI veel pagina's maken zonder waarde voor gebruikers | Deels | AI-samenvattingen, miljoenen stuks. Of ze waarde toevoegen is de vraag. Westbrook vond ook een weerpagina met verouderde informatie. |
| Content van verschillende pagina's samenvoegen zonder waarde toe te voegen | Mogelijk | Elke pagina combineert openbare berichten van mensen en pagina's op Facebook. |
| Feeds of zoekresultaten scrapen | Niet gezien | De bron is het eigen platform van Facebook. |
| Meerdere sites om de schaal te verbergen | Nee | Eén map op facebook.com. |
| Pagina's die nergens op slaan maar zoekwoorden bevatten | Niet gezien | De pagina's zijn leesbaar. Ze overlappen wel sterk. |
Mijn lezing: letterlijk passen twee voorbeelden gedeeltelijk. Maar de toets in Googles zin gaat over het hoofddoel, rankings manipuleren in plaats van lezers helpen. Dat is een toets op bedoeling, en bedoeling zie je alleen aan patronen. Het patroon hier is zichtbaar in één onderwerp.
Hoeveel pagina's heb je nodig over padel?
Westbrook vond meer dan 180 Engelstalige pagina's over padel tennis, zonder dat er volgens hem redactioneel naar gekeken lijkt te zijn. Onderaan elke pagina staat een blok "More like this" met links naar andere pagina's in dezelfde map, schrijft hij en bevestigt Gabe. Zo ziet dat er in Google uit:
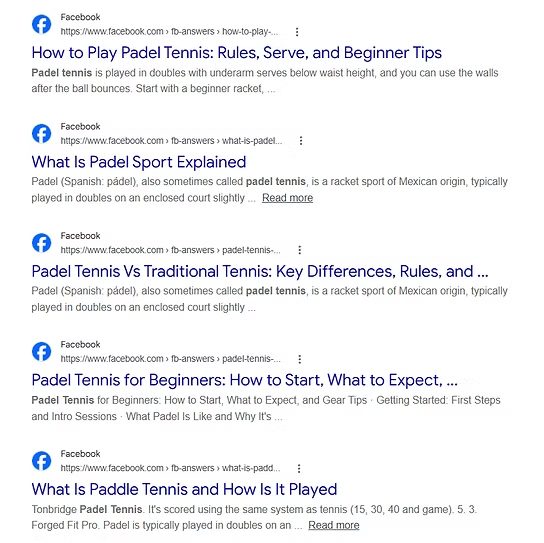
Vijf titels, vijf varianten van "wat is padel en hoe speel je het". Googles beleid over doorway abuse, door Westbrook geciteerd, gaat over pagina's "created to rank for specific, similar search queries". Dit lijkt daar sterk op.
Facebook blokkeert AI-bots voor deze pagina's, Googlebot niet
Op 8 november rond 09:00 UTC lazen wij facebook.com/robots.txt. Dit staat erin:
| Crawler | Regel voor /fb-answers/ |
|---|---|
| GPTBot, ClaudeBot, PerplexityBot, Google-Extended, Amazonbot, Applebot-Extended | Disallow: / (geen toegang) |
| Googlebot en Bingbot | Toegestaan. Googlebot krijgt 41 Disallow-regels, waaronder /meta-ai-answers/, maar geen voor /fb-answers/. |
| Sitemap in robots.txt | Onder meer groups_fb_answer_posts_0.xml.gz. Bij openen kregen wij HTTP 403, dus de inhoud kennen we niet. |
Dat past bij wat Westbrook vond: taalmodellen kunnen deze pagina's niet crawlen, Googles AI Overviews citeren ze wel. Het bewijst ook dat Facebook weet hoe je een map met AI-antwoorden voor Googlebot dichtzet, want /meta-ai-answers/ staat dicht. Wat het niet bewijst: dat /fb-answers/ bewust openstaat. Wat er in de andere map zit, weten we niet. En een robots.txt is een verzoek, geen slot.
Onze eigen stelling heeft nu een tegenvoorbeeld
In september schreven we dat Google scaled content abuse weer straft. Dat gaat over handmatige acties op sites die vaak veel kleiner zijn. Facebook is het tegenvoorbeeld: Westbrook meldt dat de pagina's de spam update van september overleefden, die liep van 24 september tot 8 oktober.
Maar dat is één update en een paar maanden. Google heeft zich, voor zover wij vonden, niet uitgesproken en Meta volgens Westbrook ook niet. Over een kleine site zei John Mueller dat Googles systemen het geloof in die site kunnen verliezen. Hoe dat vertrouwen bij facebook.com meeweegt, weten we niet. Barry Schwartz verwacht dat de pagina's "won't be indexed too much longer". Dat is een gok, geen bericht.
En wij verkopen plaatsingen. "Facebook komt ermee weg" is precies de zin waarmee iemand goedkope tekst gaat opschalen. Het is een zwak argument. Facebook heeft miljarden eigen berichten als bron, jij hebt een tekstgenerator en een prompt.
Staat jouw merk in een AI-samenvatting van Facebook?
Westbrook geeft zelf een zoektip. Doe dit één keer voor je merknaam:
- Zoek in Google op
site:facebook.com/fb-answers "jouwmerknaam". - Open de eerste pagina en lees welke berichten als bron staan.
- Noteer de URL en de datum. De pagina's zijn statisch en Westbrook vond geen manier om een eigen bericht eruit te halen.
Doe dit om te zien wat er over je gezegd wordt. Niet om zelf pagina's na te maken.
Januari: buigt de grafiek af?
De volgende meting is Semrush voor november en december. Blijft /fb-answers/ rond de 40 miljoen bezoeken per maand, dan is dit geen kortstondige uitglijder. Dat het blijft ranken bewijst niet dat Google het bewust toestaat: een verkeersschatting laat zien dat de pagina's gevonden worden, niet waarom. Zakt het na een reactie van Google, dan is eindelijk te zien waar de grens ligt. Tot die tijd is dit één case, één platform en een schatting.
Wie plaatsingen koopt, vraagt per site hoe de pagina's ontstaan. Meer over hoe je backlinks kopen aanpakt staat bij BacklinksWinkel. Meer over wat een spam update doet staat in de kennisbank.
Websites, prijzen en pakketten vergelijken
Bekijk beschikbare websites op categorie, DR en prijs bij backlinks kopen. Zoek je hulp bij selectie en planning, bekijk dan linkbuilding uitbesteden.
Check een site voor je een link koopt
Gerelateerde Artikelen
Bing backlink achter plek 1 op apples?
Een supermarkt staat op 1 voor 'apples' en een SEO-veteraan zegt 'case closed' door een link van 4.bing.com. Wij maten: de robots.txt van 4.bing.com geeft 400, dus Google mag crawlen, maar bewijs voor de ranking ontbreekt.
Lees meer →Ahrefs DR4: subdomeinlinks naar bijna 0
Vanaf 1 december krijgt elk subdomein in Ahrefs een eigen Domain Rating. Wij maten 255 subdomeinen en 1.972 catalogusdomeinen: pagina's op startpagina's en gratis sitebouwers vallen naar bijna 0, hoofddomeinen stijgen licht.
Lees meer →Kliksprong in Search Console: bot of bug?
Sinds 31 oktober zien sommige sites ineens veel meer kliks in Search Console bij vlakke vertoningen. Bij 73 sites bleef de lijn vlak. Zo check je met drie schermen en GA4 of jouw sprong echt is.
Lees meer →Klaar om je rankings te verbeteren?
Vergelijk websites, prijzen en voorwaarden voordat je een plaatsing kiest.